Aprendizaje Profundo o Deep Learning: Conceptos y Funcionamiento
Introducción al Deep Learning
El deep learning, o aprendizaje profundo, es una subdisciplina de la inteligencia artificial (IA) que se enfoca en el desarrollo y el uso de algoritmos que intentan modelar el comportamiento humano al aprender a partir de grandes cantidades de datos. Esta técnica, en particular, se basa en redes neuronales profundas que permiten a los sistemas automatizados aprender a partir de la experiencia, mejorando su rendimiento a medida que se les proporcionan más datos.
El origen del deep learning se remonta a las primeras investigaciones sobre redes neuronales en la década de 1940. A pesar de que las ideas sobre el aprendizaje automático existían desde hace tiempo, fue solo con el aumento de la capacidad de procesamiento y la disponibilidad de grandes volúmenes de datos que el aprendizaje profundo comenzó a ganar relevancia y a demostrar su potencial en diversas aplicaciones. Hoy en día, es común encontrar este enfoque en áreas como el reconocimiento de voz, la visión por computadora y el procesamiento del lenguaje natural.
A diferencia de los métodos tradicionales de aprendizaje automático, que a menudo dependen de la ingeniería de características manuales para extraer datos relevantes, el deep learning permite a las máquinas realizar esta tarea de manera automática. Esta característica se convierte en una ventaja al trabajar con datos heurísticos o no estructurados, como imágenes o texto, donde la complejidad y la variabilidad son muy altas.
La importancia del deep learning en el contexto tecnológico actual es indiscutible. Las organizaciones están aprovechando esta poderosa herramienta para mejorar sus productos y procesos, volviéndose más eficientes y competitivas. Al perfeccionar los algoritmos de deep learning, las empresas pueden descubrir patrones sutiles en los datos, lo que puede resultar en avances significativos en innumerables campos, desde la medicina hasta la automoción.
Estructura de las Redes Neuronales
Las redes neuronales son sistemas computacionales inspirados en la estructura del cerebro humano, diseñados para reconocer patrones y aprender a partir de datos. Estas redes se componen de múltiples capas de neuronas artificiales, que son los elementos fundamentales que permiten el procesamiento de información.
La estructura básica de una red neuronal incluye tres tipos de capas: la capa de entrada, las capas ocultas y la capa de salida. La capa de entrada recibe las señales o datos iniciales, que luego son procesados por las neuronas en las capas ocultas. Cada neurona en estas capas aplica una función de activación, que decide si la neurona debe activarse o no, en función de la suma ponderada de las entradas que recibe. Algunas funciones de activación comunes son la función sigmoide, la tangente hiperbólica y la rectificación lineal (ReLU).
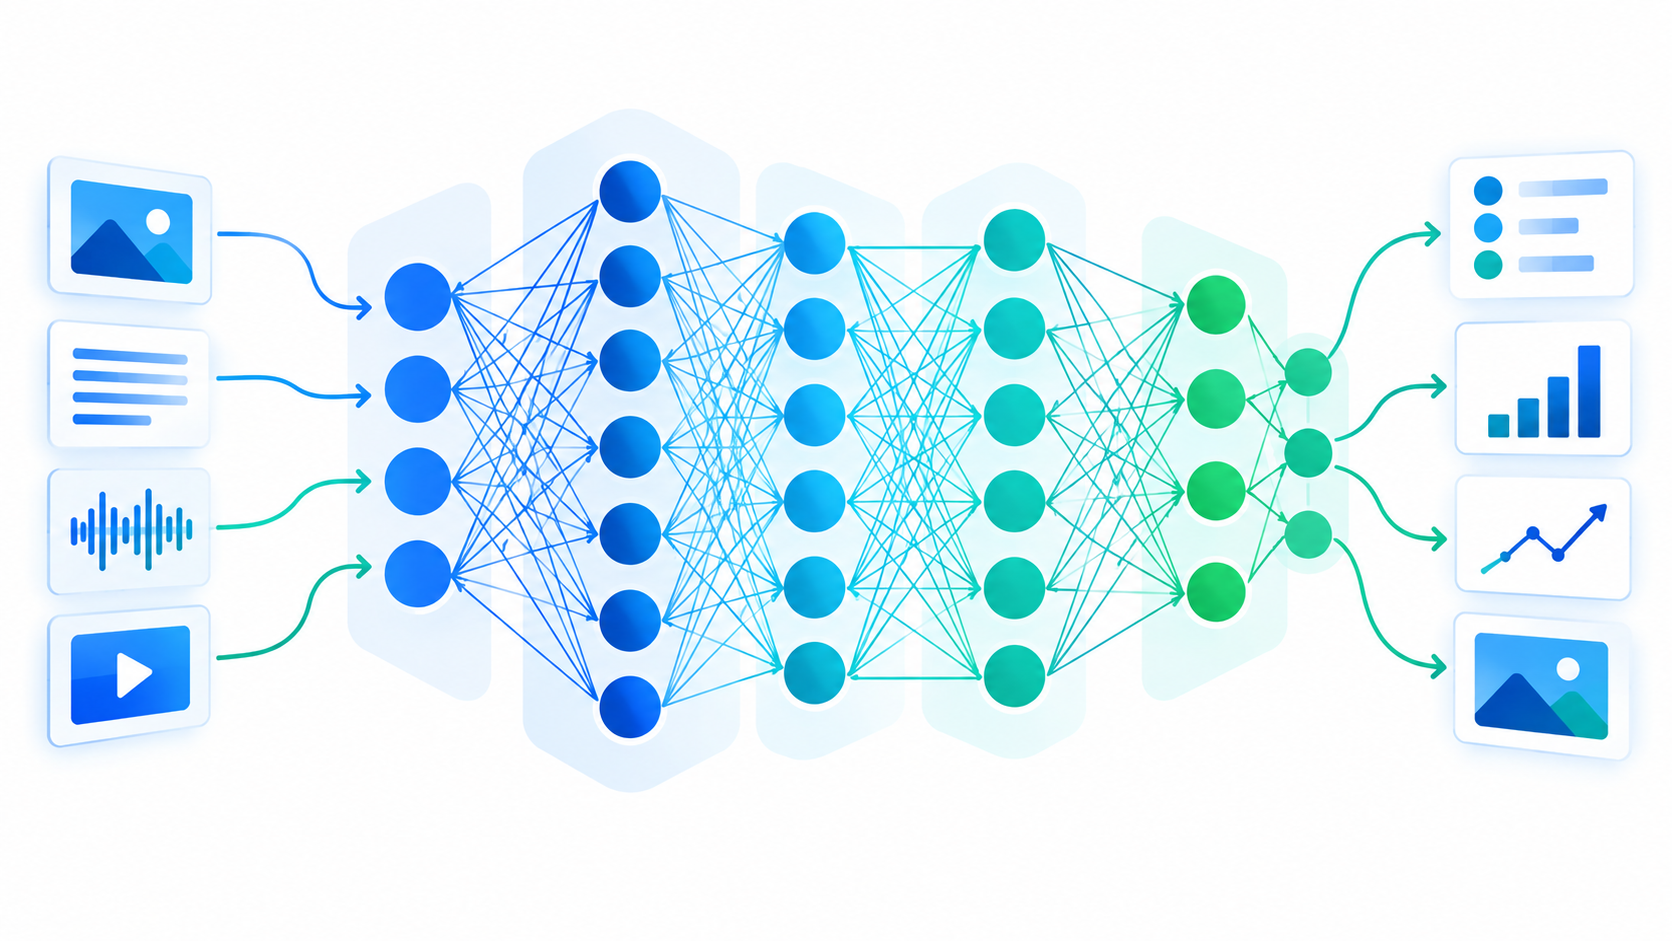
La capa de salida produce el resultado final de la red neuronal, que puede ser una clasificación, una predicción o cualquier otro tipo de respuesta deseada. La salida es influenciada por las activaciones de las neuronas en las capas ocultas, que han procesado la información según sus respectivas funciones de activación y pesos ajustados durante el entrenamiento.
Además, las redes pueden presentar diferentes arquitecturas, dependiendo de la aplicación específica. Por ejemplo, las redes neuronales convolucionales (CNN) son eficaces para el procesamiento de imágenes, mientras que las redes neuronales recurrentes (RNN) son más adecuadas para el procesamiento de secuencias temporales. Cada tipo de red tiene su propia disposición de capas y funciones de activación, lo que determina su rendimiento y eficacia en diversas tareas.
Funcionamiento de un Algoritmo de Deep Learning
El funcionamiento de un algoritmo de deep learning se basa en el procesamiento de datos a través de múltiples capas de redes neuronales. Comienza con la entrada de datos, donde las características relevantes de los datos son transformadas en un formato que el modelo puede entender. Cada elemento de entrada se asigna a un conjunto de nodos en la primera capa de la red neuronal.
Una vez que la información entra en la red, se lleva a cabo el proceso de propagación hacia adelante. Durante este proceso, los datos son procesados a través de capas sucesivas. Cada capa aplica una serie de transformaciones matemáticas, utilizando funciones de activación que introducen no linealidades en el modelo. A medida que los datos fluyen a través de las capas, se generan representaciones cada vez más abstractas y complejas de la información inicial.
Cuando la información alcanza la última capa, se produce la salida del modelo. Esta salida puede adoptar diversas formas, dependiendo del tipo de tarea que se esté llevando a cabo, como clasificaciones en el caso de problemas de clasificación o predicciones en el caso de problemas de regresión. Sin embargo, el aprendizaje no se detiene aquí. Después de calcular la salida, se necesita evaluar cuán precisa es la predicción. Para ello, se utiliza una función de pérdida que mide la discrepancia entre la salida del modelo y la realidad.
Para mejorar el rendimiento del modelo, se aplica el proceso de propagación hacia atrás. En este paso, se calcula el gradiente de la función de pérdida en relación a los pesos de la red y se utilizan técnicas de optimización, como el descenso por el gradiente, para ajustar esos pesos. Este ciclo de propagación hacia adelante y hacia atrás se repite en múltiples iteraciones conocidas como épocas, permitiendo que el algoritmo de deep learning aprenda y ajuste sus parámetros hasta que alcance un rendimiento óptimo.
Entrenamiento de Modelos de Deep Learning
El entrenamiento de modelos de Deep Learning es un proceso crucial que involucra varias etapas, cada una de las cuales desempeña un papel fundamental en la creación de un modelo efectivo. El primer paso en este proceso es la preparación de los datos. Es esencial contar con conjuntos de datos de alta calidad, ya que la precisión y efectividad del modelo dependen en gran medida de la información que se le proporcione. Esto incluye limpiar los datos, eliminar valores atípicos y normalizar o escalar las características según sea necesario.
Una vez que los datos están preparados, se debe abordar la selección de hiperparámetros. Estos hiperparámetros pueden incluir la tasa de aprendizaje, el número de capas en la red neuronal y el tamaño de los lotes, entre otros. La elección correcta de estos parámetros es crítica, ya que puede afectar significativamente la capacidad del modelo para aprender y generalizar a partir de los datos de entrenamiento. Normalmente, se utilizan técnicas como la validación cruzada para encontrar el conjunto óptimo de hiperparámetros, ayudando a evitar problemas como el sobreajuste.
La validación del modelo es la siguiente etapa del proceso de entrenamiento. Este paso implica evaluar el modelo utilizando un conjunto de datos que no fue utilizado durante el entrenamiento. Esta evaluación es fundamental para entender el rendimiento del modelo y su capacidad para hacer predicciones precisas en datos no vistos. El rendimiento del modelo se mide a menudo utilizando métricas como la precisión, la recuperación y el puntaje F1. Es importante asegurarse de que el modelo haya aprendido a detectar patrones en los datos en lugar de simplemente memorizar información, lo que puede resultar en un desempeño deficiente en la práctica.
Aplicaciones del Deep Learning
El aprendizaje profundo, o deep learning, ha transformado diversas industrias a través de su capacidad para procesar y analizar grandes volúmenes de datos. Una de las áreas más destacadas de su aplicación es la visión por computadora, donde se utilizan redes neuronales profundas para tareas como el reconocimiento facial, la clasificación de imágenes y la detección de objetos. Estos sistemas han sido implementados en seguridad, sistemas de vigilancia y aplicaciones comerciales, donde el reconocimiento preciso y rápido es crucial.
Otra área en la que el aprendizaje profundo ha tenido un impacto significativo es el procesamiento del lenguaje natural (NLP, por sus siglas en inglés). Esta tecnología permite a las máquinas interpretar, generar y responder a interacciones humanas en lenguaje natural. Los modelos de deep learning se utilizan ampliamente en chatbots, asistentes virtuales y sistemas de traducción automática, facilitando la comunicación y mejorando la experiencia del usuario en plataformas digitales.
Además, el análisis de datos se ha beneficiado enormemente del aprendizaje profundo. Los algoritmos de deep learning son capaces de descubrir patrones complejos en conjuntos de datos que serían difíciles de identificar mediante métodos tradicionales. Esto es particularmente valioso en campos como la salud, donde se emplean para predecir enfermedades y personalizar tratamientos basados en la información genética y médica de los pacientes. Otros sectores como las finanzas y el marketing también han aprovechado el deep learning para optimizar la toma de decisiones y la segmentación de clientes, respectivamente.
En conclusión, las aplicaciones del aprendizaje profundo abarcan un amplio espectro, desde la visión por computadora hasta el procesamiento del lenguaje natural y el análisis de datos. La capacidad de estos modelos para aprender de grandes volúmenes de datos está revolucionando diversas industrias y transformando la forma en que interactuamos con la tecnología.
Ventajas del Deep Learning sobre el Aprendizaje Automático Tradicional
El aprendizaje profundo, una rama del aprendizaje automático, ha demostrado poseer diversas ventajas sobre los métodos tradicionales de aprendizaje automático. Entre estas ventajas, la capacidad de procesar y aprender de grandes volúmenes de datos es particularmente significativa. Los algoritmos de deep learning están diseñados para lidiar con datos en múltiples dimensiones, permitiendo un aprendizaje más efectivo y representativo de las complejidades presentes en conjuntos de datos extensos.
Además, el deep learning se caracteriza por su estructura jerárquica de redes neuronales, que permite modelar características y patrones de forma más precisa. A diferencia de las técnicas tradicionales, que usualmente requieren ingeniería manual de características, los modelos de deep learning pueden automaticamente captar las representaciones más relevantes de los datos. Esto resulta en una mejora notable en la precisión de las predicciones y el reconocimiento de patrones.
Otra ventaja relevante es la capacidad del aprendizaje profundo para realizar tareas complejas como la visión por computadora y el procesamiento del lenguaje natural. Estas tareas que antes eran difíciles de implementar con métodos tradicionales, se han vuelto más accesibles gracias al desarrollo y la evolución de las arquitecturas de redes neuronales, como las redes convolucionales y recurrentes.
Sin embargo, es importante señalar que el uso de deep learning no está exento de desafíos. Requiere de recursos computacionales significativos y una cuidadosa selección de datos de entrenamiento. No obstante, cuando estos requisitos se cumplen, las ventajas del deep learning superan frecuentemente a las de las metodologías de aprendizaje automático tradicionales, ofreciendo soluciones más robustas y eficientes en contextos donde los datos presentan complejidades intrínsecas.
Desafíos y Limitaciones del Deep Learning
El aprendizaje profundo, a pesar de sus notables avances y aplicaciones, se enfrenta a múltiples desafíos y limitaciones que pueden restringir su efectividad y expansión. Uno de los problemas más significativos es la necesidad de grandes cantidades de datos etiquetados. Para entrenar un modelo de aprendizaje profundo con precisión, es fundamental contar con conjuntos de datos que no solo sean extensos, sino también representativos del problema en cuestión. Esta necesidad puede resultar en un considerable esfuerzo y recursos, lo que limita la capacidad de implementar estos modelos en áreas donde los datos escacean o no están debidamente etiquetados.
Además, la complejidad computacional que requiere el aprendizaje profundo es considerable. Los modelos, que suelen tener miles o millones de parámetros, necesitan de potentes recursos computacionales para su entrenamiento y ajuste. Esto puede ser un obstáculo considerable para las pequeñas empresas o investigadores que pueden no tener acceso a la infraestructura necesaria. La alta demanda computacional también puede traducirse en un mayor consumo de energía, lo cual plantea preocupaciones sobre la sostenibilidad de estas tecnologías a largo plazo.
Por otro lado, los problemas de sobreajuste son comunes en modelos de aprendizaje profundo. Este fenómeno ocurre cuando un modelo aprende extremadamente bien los detalles y el ruido del conjunto de datos de entrenamiento, en detrimento de su capacidad para generalizar a datos no vistos. A pesar de que existen técnicas para mitigar el sobreajuste, como la regularización y el uso de validación cruzada, este sigue siendo un desafío importante a tener en cuenta durante el desarrollo de modelos de aprendizaje profundo.
En conclusión, aunque el aprendizaje profundo presenta oportunidades sin precedentes en diversos campos, los desafíos como la necesidad de grandes volúmenes de datos, la complejidad computacional y los problemas de sobreajuste limitan su implementación y eficacia, lo que subraya la importancia de seguir avanzando en la investigación y el desarrollo de soluciones que aborden estas cuestiones.
El Futuro del Deep Learning
A medida que la tecnología avanza a un ritmo acelerado, el deep learning se posiciona como un campo fundamental en la inteligencia artificial. Las tendencias futuras sugieren un aumento notable en la adopción de métodos de aprendizaje profundo en una variedad de industrias. Esto incluye, pero no se limita a, sectores como la salud, la automoción y las finanzas. Por ejemplo, en la atención sanitaria, se espera que los algoritmos de aprendizaje profundo mejoren la precisión de los diagnósticos, permitiendo un tratamiento más temprano y personalizado de enfermedades. Además, el uso de imágenes médicas y datos genómicos podrían ser revolucionados mediante estas tecnologías.
En el ámbito automotriz, el deep learning continúa siendo fundamental para el desarrollo de vehículos autónomos. A medida que mejoran las capacidades de percepción y procesamiento de datos, los coches serán capaces de interpretar su entorno de manera más eficaz, aumentando así la seguridad de las carreteras. Por otro lado, en la sector financiero, el aprendizaje profundo promete mejorar la detección de fraudes y el análisis predictivo de mercados, facilitando decisiones más informadas y rápidas.
Sin embargo, el crecimiento del deep learning también plantea preocupaciones éticas y potenciales desafíos. La responsabilidad en el uso de datos, la transparencia de los algoritmos y el sesgo inherente en los modelos de aprendizaje son cuestiones que demandan atención cuidadosa. Como resultado, la regulación, así como el desarrollo de modelos justos y éticos, se convertirán en aspectos críticos del futuro del aprendizaje profundo.
En conclusión, el futuro del deep learning es prometedor, con posibilidades de transformar radicalmente diversas industrias. A medida que esta tecnología evoluciona, su impacto en la sociedad podría ser profundo, haciendo necesario un enfoque equilibrado que considere tanto los beneficios como los desafíos que presenta.
Conclusiones
El aprendizaje profundo ha transformado significativamente el panorama de la inteligencia artificial en los últimos años. Estas tecnologías han permitido avances notables en diversos campos, desde el procesamiento del lenguaje natural hasta la visión por computadora, mostrando un potencial sin precedentes para resolver problemas complejos que anteriormente parecían insuperables. A través de redes neuronales profundas, los sistemas de inteligencia artificial han logrado captar patrones intrincados en grandes volúmenes de datos, lo que ha sido un factor determinante en su creciente adopción en muchas industrias.
Es vital reconocer cómo el deep learning impacta en el desarrollo de nuevas aplicaciones que mejoran la eficiencia y la efectividad en áreas como la medicina, la automoción y la educación. Estos avances no solo permiten a las empresas optimizar sus operaciones, sino que también proporcionan a los investigadores herramientas poderosas para el análisis de datos, permitiendo acelerar descubrimientos importantes. Por ejemplo, en la atención médica, la implementación de algoritmos de aprendizaje profundo ha mejorado los diagnósticos y el tratamiento de enfermedades, mostrando resultados prometedores en la detección temprana de afecciones críticas.
A mediano y largo plazo, el potencial del aprendizaje profundo parece ilimitado, especialmente con la continua evolución de la potencia computacional y la gran disponibilidad de datos. Sin embargo, también es crucial abordar los retos éticos y las consideraciones de seguridad asociadas con el uso de estas tecnologías. La transparencia de los modelos, la reducción de sesgos y la protección de la privacidad son aspectos que deben ser priorizados para garantizar un futuro en el que el aprendizaje profundo se aplique de manera responsable y benéfica para la sociedad.
En resumen, el aprendizaje profundo no solo está cambiando la forma en que interactuamos con la tecnología, sino que también está estableciendo las bases para una nueva era de innovación en inteligencia artificial. A medida que avancemos, será importante seguir explorando y desarrollando esta área, optimizando sus beneficios y comprendiendo mejor sus implicaciones en el mundo moderno.
Deja una respuesta